Domain diosmin.de kaufen?
Wir ziehen mit dem Projekt
diosmin.de um.
Sind Sie am Kauf der Domain
diosmin.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain diosmin.de kaufen?
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **


Ähnliche Suchbegriffe für Informationsextraktion
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Wilhelms, Theresia: Krampfadern natürlich behandelnKrampfadern natürlich behandeln , Venen in 12 Schritten ganzheitlich stärken. Mit vielen Empfehlungen aus der chinesischen Medizin , Schalter & Relais > Autoelektrik , Erscheinungsjahr: 20170109, Produktform: Kartoniert, Autoren: Wilhelms, Theresia, Seitenzahl/Blattzahl: 144, Abbildungen: 30 Abbildungen, Keyword: Traditionelle Chinesische Medizin; TCM; Alternative Medizin; Bewegung; Gesundheits-Ratgeber, Fachschema: Krampfader~Kochen / Biologisch, alternativ, Trennkost, Vollwertkost~Bodyshaping~Bodywatching~Fitness~Trimmen (fit machen)~Gesundheit (allgemein)~Sport / Ernährung~Farbfotografie~Fotografie~Photo~Photographie, Fachkategorie: Kochen: Gesundheit und Vollwertkost~Komplementäre Therapien, Heilverfahren und Gesundheit~Fotografie, Warengruppe: HC/Fotografieren/Filmen/Videofilmen, Fachkategorie: Fitness und Ernährung, Thema: Orientieren, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Schlütersche Verlag, Verlag: Schlütersche Verlag, Verlag: humboldt Verlag, Länge: 151, Breite: 206, Höhe: 13, Gewicht: 356, Produktform: Kartoniert, Genre: Sachbuch/Ratgeber, Genre: Sachbuch/Ratgeber, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0006, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 147502522,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Angewandte Informationsextraktion und Sentimentanalyse, Taschenbuch von Ashraf Uddin,Rajesh Piryani,Vivek Kumar Singh, Verlag Unser Wissen,Angewandte Informationsextraktion Und Sentimentanalyse, Taschenbuch Von Ashraf Uddin,rajesh Piryani,vivek Kumar Singh, Verlag Unser Wissen, 978-620-9-62581-7, Seitenanzahl: 8043,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Bereichsspezifische Informationsextraktion für semantische Annotation, Taschenbuch von Zeeshan Ahmed, BoD - Books on Demand, 978-620-2-73428-8Bereichsspezifische Informationsextraktion Für Semantische Annotation, Taschenbuch Von Zeeshan Ahmed, Bod - Books On Demand, 978-620-2-73428-8, Seitenanzahl: 8426,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **

Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Angebotsbeschreibungen für Online-Einkaufsportale zur automatischen Klassifizierung und Informationsextraktion mittels RekursiverAngebotsbeschreibungen Für Online-einkaufsportale Zur Automatischen Klassifizierung Und Informationsextraktion Mittels Rekursiver Transitionsnetzwerke, Taschenbuch Von Anja Klein, Grin, 978-3-668-14793-5, Seitenanzahl: 6427,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wilhelms, Theresia: Krampfadern natürlich behandelnKrampfadern natürlich behandeln , Venen in 12 Schritten ganzheitlich stärken. Mit vielen Empfehlungen aus der chinesischen Medizin , Schalter & Relais > Autoelektrik , Erscheinungsjahr: 20170109, Produktform: Kartoniert, Autoren: Wilhelms, Theresia, Seitenzahl/Blattzahl: 144, Abbildungen: 30 Abbildungen, Keyword: Traditionelle Chinesische Medizin; TCM; Alternative Medizin; Bewegung; Gesundheits-Ratgeber, Fachschema: Krampfader~Kochen / Biologisch, alternativ, Trennkost, Vollwertkost~Bodyshaping~Bodywatching~Fitness~Trimmen (fit machen)~Gesundheit (allgemein)~Sport / Ernährung~Farbfotografie~Fotografie~Photo~Photographie, Fachkategorie: Kochen: Gesundheit und Vollwertkost~Komplementäre Therapien, Heilverfahren und Gesundheit~Fotografie, Warengruppe: HC/Fotografieren/Filmen/Videofilmen, Fachkategorie: Fitness und Ernährung, Thema: Orientieren, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Schlütersche Verlag, Verlag: Schlütersche Verlag, Verlag: humboldt Verlag, Länge: 151, Breite: 206, Höhe: 13, Gewicht: 356, Produktform: Kartoniert, Genre: Sachbuch/Ratgeber, Genre: Sachbuch/Ratgeber, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0006, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 147502522,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
-
Angewandte Informationsextraktion und Sentimentanalyse, Taschenbuch von Ashraf Uddin,Rajesh Piryani,Vivek Kumar Singh, Verlag Unser Wissen,Angewandte Informationsextraktion Und Sentimentanalyse, Taschenbuch Von Ashraf Uddin,rajesh Piryani,vivek Kumar Singh, Verlag Unser Wissen, 978-620-9-62581-7, Seitenanzahl: 8043,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Bereichsspezifische Informationsextraktion für semantische Annotation, Taschenbuch von Zeeshan Ahmed, BoD - Books on Demand, 978-620-2-73428-8Bereichsspezifische Informationsextraktion Für Semantische Annotation, Taschenbuch Von Zeeshan Ahmed, Bod - Books On Demand, 978-620-2-73428-8, Seitenanzahl: 8426,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Modell zur Informationsextraktion für Afan Oromo Nachrichtentexte, Taschenbuch von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7Modell Zur Informationsextraktion Für Afan Oromo Nachrichtentexte, Taschenbuch Von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7, Seitenanzahl: 6849,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
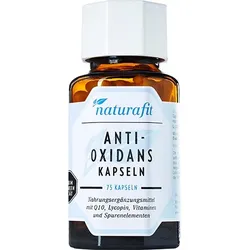
NATURAFIT Antioxidans Kapseln 75 StNahrungsergänzungsmittel mit Q10, Lycopin, Vitaminen und Spurenelementen Antioxidantien agieren wie ein Schutzschild für unseren Körper. Freie Radikale, welche aufgrund ihres fehlenden Elektrons nicht vollständig sind, gehen aggressiv und ohne Rücksicht vor, um wieder eine Vollständigkeit zu erlangen. Diese Täter rauben unseren gesunden, intakten Zellen ihre positiven Eigenschaften – dabei kommt es zur Oxidation. naturafit Antioxidanskapseln halten bei solchen Vorgängen den freien Radikalen ein Stopschild vor und fangen diese ein. Bei den naturafit Antioxidationskapseln handelt es sich daher um eine Mischung aus wichtigen antioxidativen Inhaltsstoffen. Die enthaltenen Spurenelemente Zink, Mangan und Selen tragen dazu bei, die Zellen vor oxidativem Stress zu schützen und haben eine Funktion bei der Zellteilung. Ergänzt werden sie durch Vitamin C und Vitamin E, diese tragen bei: – zu einer normalen Funktion des Immunsystems – zu einem normalen Energiestoffwechsel naturafit bietet Ihnen traditionell ausschließlich Reinsubstanzen mit bester Bioverfügbarkeit in Premium Apotheken Qualität. In unserer Manufaktur für Mikronährstoffe werden Nahrungsergänzungsmittel in Handarbeit hergestellt. Durch unser einzigartiges Verfahren können wir produktschonend und ohne Rieselhilfen produzieren. Damit unsere Premium Apotheken Qualität erhalten bleibt, verwenden wir für unsere naturafit Produkte ausschließlich braunes Apothekerglas. Damit leisten wir nicht nur einen Beitrag zur Umwelt, sondern verhindern auch, dass unter anderem Plastikweichmacher in das Produkt gelangen - denn nur Glas bewahrt absolute Reinheit. 75 Kapseln Täglich 3 Kapseln zur ergänzenden Versorgung Inhalt pro 3 Kapseln (Tagesempfehlung): 30 mg Q10 nat. . 120 mg Tomaten-Extrakt . 6 mg enthält natürliches Lycopin . 500 mg Vitamin C . 300 mg Vitamin E . 4,8 mg Beta-Carotin . 33 mg Selenhefe . 66 μg enthält natürliches Selen . 23,4 mg Zinkcitrat . 7,5 mg enthält Zink . 7,5 mg Mangansulfat . 2,5 mg enthält Mangan Zutaten: Vitamin C, Vitamin E (Alpha-Tocopherolacetat), Hydroxypropylmethylcellulose (Kapselhülle), Stärke, Maltodextrin, Füllstoff mikrokristalline Cellulose, Speisestärke, Maisstärke, Xanthan Gum, Tomaten-Extrakt, Antioxidationsmittel Ascorbylpalmitat und DL-Alpha-Tocopherol, Lalmin Se 2000, (Selenhefe), Coenzym Q10 natürlich, Zinkcitrat, Mangansulfat, Beta-Carotin,Trennmittel Siliciumdioxid lactosefrei glutenfrei gelatinefrei farbstofffrei vegan pflanzliche Kapselhülle ohne Gentechnik Die angegebene empfohlene tägliche Verzehrsmenge darf nicht überschritten werden. Das Nahrungsergänzungsmittel sollte nicht als Ersatz für eine ausgewogene und abwechslungsreiche Ernährung verwendet werden. Außerhalb der Reichweite von Kindern lagern. Kühl und trocken lagern. Nach Anbruch stets fest verschließen und zügig aufbrauchen. Starke Raucher sollten das Produkt nicht über mehrere Monate einnehmen. Naturafit GmbH Am Sandfeld 9-11 91341 Röttenbach Hergestellt in Deutschland26,06 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
-
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.